

El HTML semántico consiste en marcar cada parte de una página según lo que es. El menú va en una etiqueta nav, el artículo en article y cada título de sección en su H2. Durante años se ha vendido como un truco para posicionar, y Google lo ha desmentido más de una vez.
Con ChatGPT o Claude la cosa cambia, porque no ven tu diseño. Leen el código que reciben y poco más. Si ya estás trabajando el SEO para IA, es un punto que conviene revisar.
Queríamos comprobarlo con páginas reales, así que leímos tres de marketinhouse como lo haría un rastreador de IA. Esperábamos encontrar un problema y encontramos otro distinto.
Puntos Clave
- Google no premia el HTML semántico como factor de posicionamiento. En su guía de julio de 2026 pide cuidar la legibilidad y no obsesionarse con un código pérfecto. (Google Search Central).
- GPTBot, ClaudeBot y PerplexityBot no ejecutan JS. Lo que no vengta en el HTML del servidor no le llega.
- En nuestros dos post, los extractores recuperaron entre el 96,8% y el 98,4% del contenido con el marcado actual.
- La página de servicio fue la más frágil. Readability solo recuperó el 3,8% del su contenido.
- Los fallos que más afectaron fueron los títulos con la etiqueta equivocada y los datos metidos en carruseles.
Qué aporta el HTML semántico al SEO en Google
Lo que Google ha dicho sobre etiquetas y encabezados
Google lleva años diciendo lo mismo. En 2023, John Mueller explicó en un vídeo de Search Central que el HTML semántico ayuda a entender una página, pero no la hace subir en los resultados. También contó que sus sistemas tratan igual section, article y div cuando agrupan bloques de texto.
En julio de 2026, Google lo dejó por escrito en su guía de optimización para las funciones de IA generativa. Sobre el HTML semántico dice literalmente “céntrate en la legibilidad para las personas y no te preocupes por tener un código perfecto”.
Para aparecer en AI Overviews o en el modo IA, la página solo tiene que estar indexada y poder mostrarse con un fragmento.
¿Dónde sí ayuda en buscadores?
Aun así, marcar bien la página tiene ventajas. Con los encabezados bien ordenados, Google entiende qué pregunta responde cada bloque. De ahí salen muchos fragmentos destacados y los enlaces que te llevan directos a una sección desde el resultado.
Las tablas y listas reales se aprovechan mejor que el texto colocado con bloques genéricos. Además, los lectores de pantalla usan ese mismo marcado, así que ganas accesibilidad sin hacer nada más.
¿Cómo llega tu página a una respuesta de ChatGPT?
Ni OpenAI ni Anthropic explican cómo procesan las páginas, pero con lo que se sabe se puede reconstruir el recorrido.
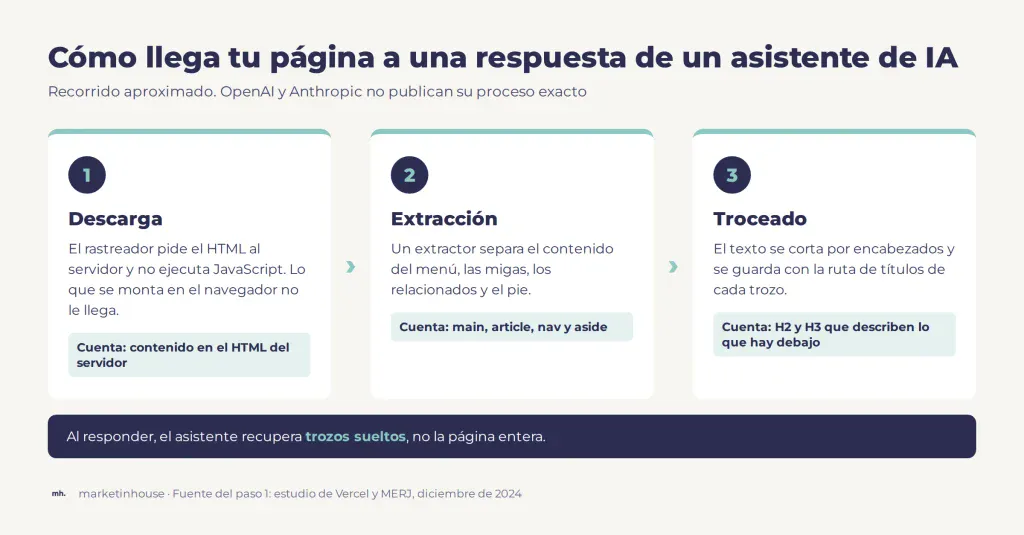
1. El rastreador descarga el HTML sin ejecutar JavaScript
En diciembre de 2024, Vercel y MERJ publicaron un análisis del tráfico de rastreadores de IA en la red de Vercel. En un mes contaron 569 millones de peticiones de GPTBot y 370 millones del rastreador de Anthropic.
Según el estudio de Vercel, ninguno de los grandes rastreadores de IA ejecuta JavaScript. Gemini es la excepción, porque usa la infraestructura de Googlebot. Si tu web monta el contenido en el navegador, a esos rastreadores les llega una página casi vacía.
En enero de 2026, Edgecomet repitió la prueba con un dominio nuevo y los logs de su servidor. Ninguno de los tres rastreadores de OpenAI renderizó Javascript.
2. Un extractor separa el contenido del menú y el pie
Después hay que separar el contenido de todo lo demás. Para eso existen extractores de código abierto como Trafilatura o Readability, una librería de Mozilla que nació para el modo lectura de Firefox y hoy usan muchas herramientas de extracción. No sabemos cuál usa cada empresa, aunque todos funcionan de forma parecida.
Se fijan en las etiquetas y en cuánto texto hay en cada bloque. Aquí el HTML semántico sí cuenta, porque un nav o un aside le dicen al extractor qué puede tirar.
3. Los encabezados dan contexto a cada fragmento
Nadie publica cómo se trocea el texto por dentro. En los sistemas de recuperación que se montan con herramientas abiertas, lo habitual es cortarlo en trozos (chunking) por encabezados y apuntar de qué título cuelga cada uno.
Google sí ha confirmado que, al responder, divide la pregunta en varias búsquedas sobre subtemas, lo que llama distribución múltiple de consultas , también conocidas como query fan-out. Y según un análisis de Dan Petrovic de diciembre de 2025, lo que llega a la respuesta son frases literales de unas 15 palabras, no páginas enteras.
Google avisa en su guía de que no hace falta partir el contenido en piezas pequeñas para su IA. Ese chunking lo hace el sistema. Lo que depende de ti es que cada H2 y cada H3 describan lo que hay debajo.
Experimento con tres páginas de marketinhouse
Cómo lo hicimos
El 28 de septiembre de 2026 descargamos tres páginas con la identidad de GPTBot y sin ejecutar JavaScript. Cogimos dos posts del blog y la página del servicio de posicionamiento SEO, que tienen plantillas distintas.
Pasamos cada una por Trafilatura y Readability para ver cuánto contenido real recuperaban. Luego troceamos el texto por encabezados y lo comparamos con el HTML que ve Google en Search Console. Al final corregimos el marcado en copias locales y volvimos a medir.
Los posts llegan casi enteros
GPTBot recibió las tres páginas completas, sin bloqueos ni versiones recortadas. Nuestra web está hecha con Bricks, que genera el contenido en el servidor, así que GPTBot y Google ven el mismo texto. La única diferencia es el índice de los posts. Se monta con JavaScript y al rastreador le llega vacío.
| Página | Extractor | Contenido recuperado | Texto ajeno al artículo |
|---|---|---|---|
| Post sobre estrategias GEO | Trafilatura | 98,4% | 0,7% |
| Post sobre estrategias GEO | Readability | 98,4% | 0,7% |
| Post sobre búsqueda generativa | Trafilatura | 96,8% | 3% |
| Post sobre búsqueda generativa | Readability | 96,8% | 3% |
| Servicio de posicionamiento SEO | Trafilatura | 100% | 13,5% |
| Servicio de posicionamiento SEO | Readability | 3,8% | 33% |
En los posts solo faltan el H1 y el subtítulo, y tampoco se pierden, porque los extractores los guardan aparte como título y descripción. Las tres tablas del segundo post llegaron como tablas. El menú, las migas, la ficha de autor y el pie quedaron fuera, porque están en nav y aside.
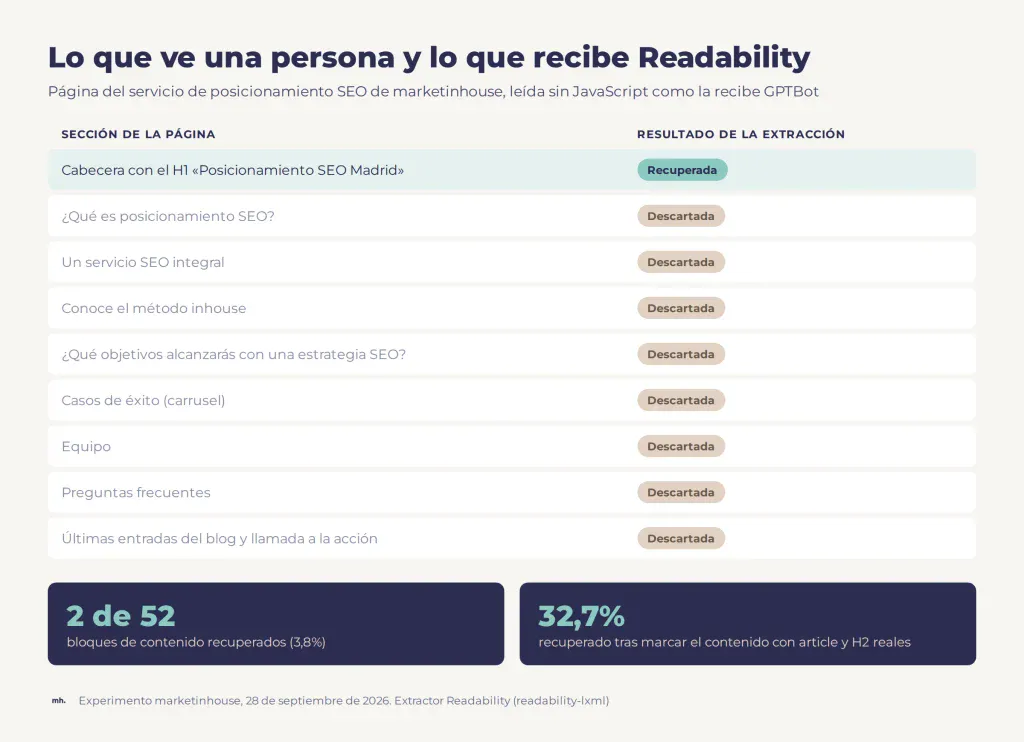
Esperé que el menú, repetido tres veces en el código, fuera el gran problema. No lo fue. Tampoco la etiqueta main duplicada que tiene la plantilla de los posts, aunque el estándar HTML no la permite.
La página de servicio es la más frágil
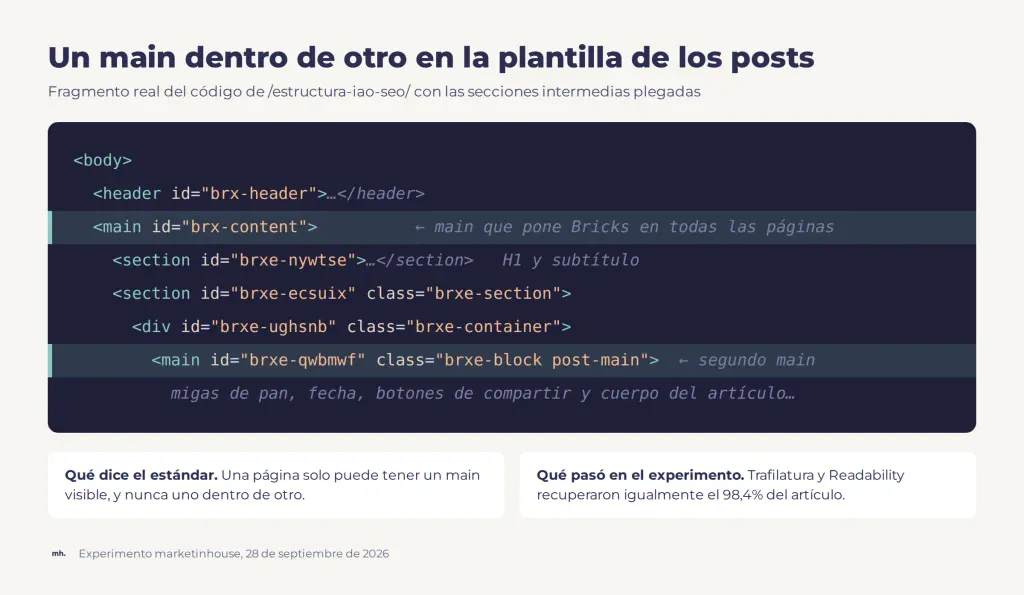
Con la página de servicio, Readability se quedó solo con la cabecera, 2 de 52 bloques de contenido. La página son doce secciones y varios carruseles sin nada que marque cuál es el contenido principal. El algoritmo se queda con el bloque más denso y descarta los demás.
Trafilatura sí la recuperó entera, pero se tragó como contenido los títulos de las últimas entradas del blog. Al trocear salió otro problema. Varios títulos de sección parecen H2, pero en el código son H4. Por eso las cuatro preguntas frecuentes acababan colgando de la sección de objetivos, y los títulos del blog formaban nueve trozos de dos palabras.
Lo que cambió al corregir el marcado
En las copias metimos el contenido en un article, pasamos las migas y el menú de anclas a nav y el bloque del blog a aside. También convertimos en H2 los títulos que ya lo parecían.
En los posts no cambió nada, como era de esperar. En la página de servicio los trozos bajaron de 22 a 11, y la mediana de palabras por trozo subió de 23 a 98. Cada pregunta frecuente quedó en su sitio. Readability pasó de recuperar el 3,8% al 32,7%, y el texto ajeno en Trafilatura bajó del 13,5% al 3,2%.
Pero al arreglar una cosa apareció otra. Con el article bien marcado, Trafilatura dejó fuera los casos de éxito y bajó al 84,6%. Están metidos en un carrusel, y el extractor lo trata como decoración. Probamos a quitar las clases del carrusel y volvió al 100%. Justo las cifras que más nos interesa que se citen dependían de ese componente.
Etiquetas semánticas HTML que cambian lo que extrae una IA
Si tu web está hecha con un constructor visual como Bricks, Elementor o Divi, esto es lo que revisaría primero.
- Un solo main por página, y un article que envuelva el contenido principal.
- Menús, migas de pan y enlaces relacionados dentro de nav o aside.
- Cada título de sección con la etiqueta que aparenta. Si se ve como un H2, que lo sea.
- Los datos importantes fuera de carruseles y pestañas, o repetidos en un texto fijo.
- Tablas reales cuando compares datos, en lugar de columnas montadas con bloques.
Lo que no cambia nada aunque lo veas en todas las guías
El main duplicado de los posts no afectó a ninguno de los dos extractores. Meter el H1 dentro del article tampoco cambió nada, porque ya llegaba como título de la página. Y Google dijo en 2023 que no distingue entre section, article y div al agrupar el texto.
Por eso, antes de tocar plantillas, merece la pena medir qué le llega de verdad a un rastreador. En nuestro caso, los posts estaban bien pese a tener un código mejorable.
Hasta dónde llega el HTML en que una IA te mencione
El HTML semántico influye en qué texto de tu página le llega a un asistente. Que luego te cite es otra historia. Ahí pesan la autoridad de la marca, lo que se dice de ella en otras webs y si tu contenido aporta algo que no esté ya en otro sitio.
En nuestro análisis de la búsqueda generativa repasamos qué tienen en común los textos que cita ChatGPT. Un buen marcado no te asegura ninguna mención. Solo evita que la pierdas por un problema técnico.
Conviene tener claros los límites de este experimento. Son tres páginas de una sola web, hecha con un único constructor. Trafilatura y Readability son una aproximación, porque OpenAI, Anthropic y Google no publican cómo extraen el contenido. Los porcentajes sirven para comparar el antes y el después. Predecir citas con ellos sería ir demasiado lejos.
Del HTML al contexto: prepara tu web para los rastreadores de IA
El HTML semántico no mueve posiciones en Google. En cambio, sí condiciona qué parte de tu página entiende un sistema de IA.
- Los rastreadores de IA no ejecutan JavaScript. El contenido tiene que venir en el HTML del servidor.
- Un post bien maquetado llega casi entero. Las páginas hechas de secciones sueltas son las que más pierden.
- Un título con la etiqueta equivocada desordena los trozos que recupera un asistente.
- Lo que metas en un carrusel puede quedarse fuera al extraer el contenido.
Nuestro consejo es empezar por descargar tus páginas como las ve GPTBot y pasarlas por un extractor. Si quieres saber cómo está tu web, no hace falta ninguna herramienta de pago. Descarga una página con la identidad de GPTBot, pásala por Trafilatura o Readability y compara lo que sale con lo que ves en pantalla. En media hora sabrás si tus títulos y tus datos llegan enteros o se quedan por el camino.